两个城市的GPU算力集群,如何实现高速互联?
发布时间:2026-11-20作者:JOJO阅读:29
当AI企业在两个不同城市部署GPU算力集群时,除了GPU计算能力,跨城市的数据传输效率也会直接影响训练任务的执行效率。尤其是涉及大规模训练数据集、模型权重文件和检查点文件传输时,普通互联网可能难以满足持续、大流量、低丢包的传输需求。
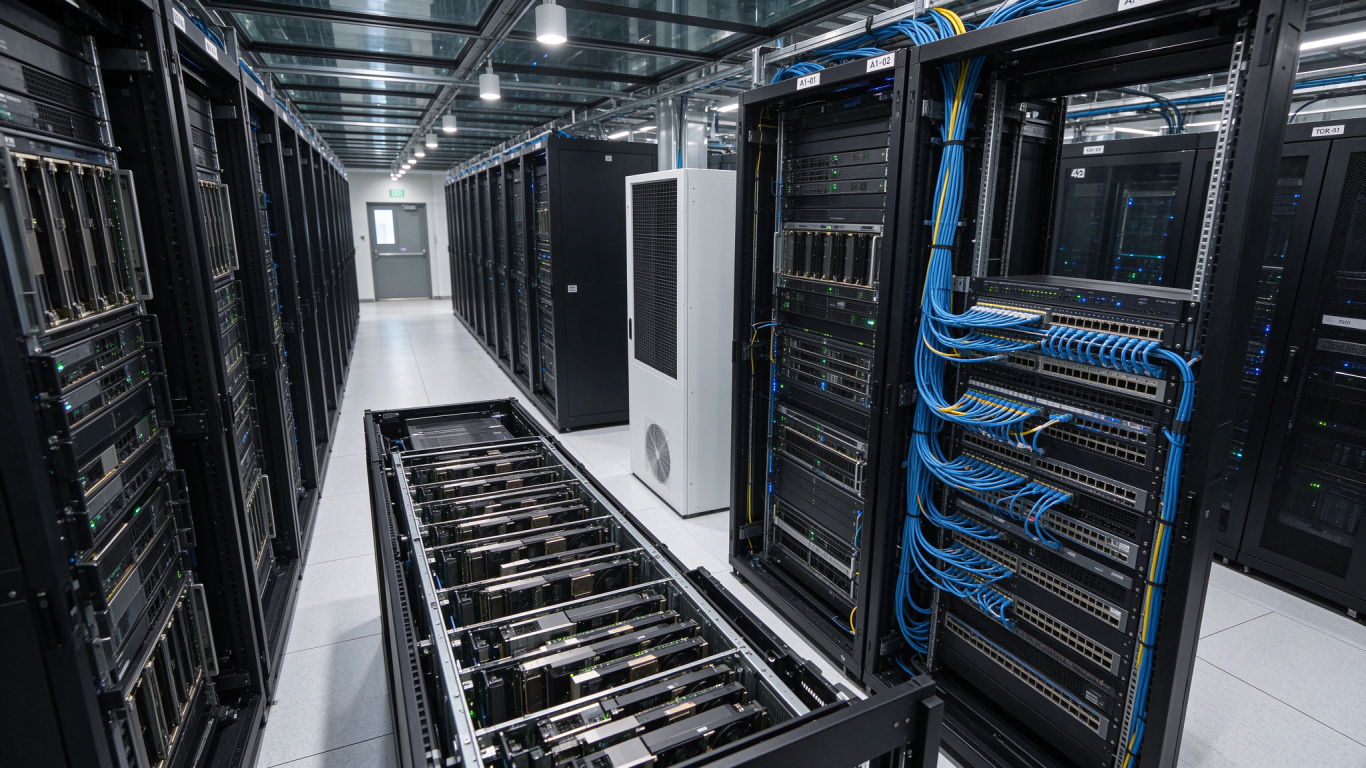
这种情况下,企业通常需要部署跨城市高速专线,实现两个算力中心之间的稳定互联。
首先,需要根据两个算力中心的地理位置、数据传输规模和业务需求选择合适的网络方案。如果两个城市之间需要长期传输TB级甚至PB级训练数据,可以考虑部署DCI专线,通过运营商骨干网络或OTN传输网络建立点对点连接,为两地算力中心提供独立的网络通道。带宽可以根据实际需求选择10Gbps、40Gbps或100Gbps,减少大文件传输所需的时间。
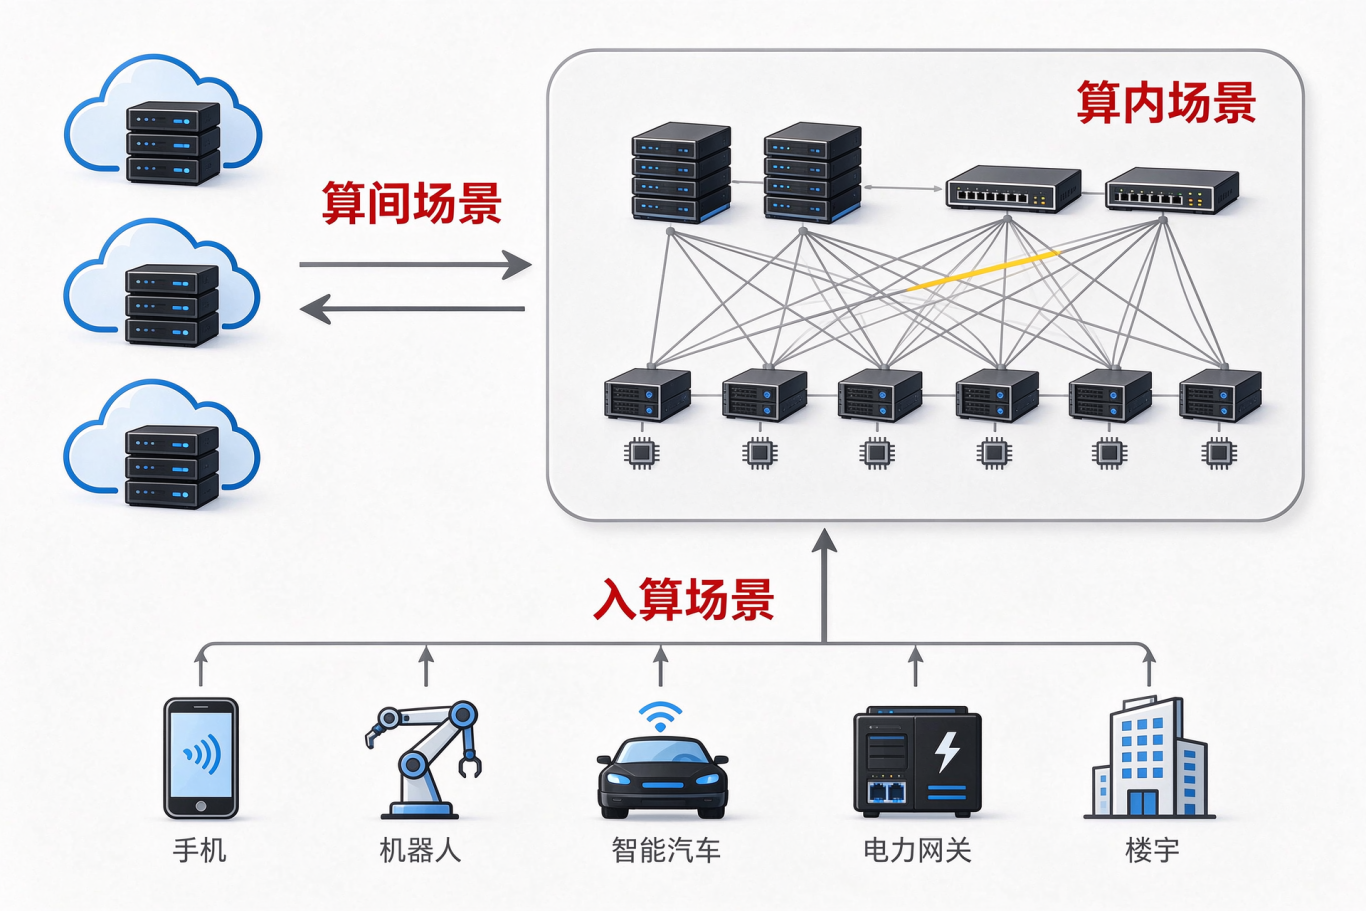
其次,网络带宽并不是唯一需要关注的指标。GPU训练过程中,数据传输还需要关注网络时延、丢包率和带宽稳定性。如果网络出现丢包,TCP传输就可能触发重传,导致实际传输速度下降。因此,除了提高带宽,还需要优化网络路由、链路质量和传输协议,必要时部署双链路冗余,避免单条线路故障影响数据同步。
在数据管理方面,企业可以在两个算力中心分别部署高速存储系统,通过分布式存储、数据缓存和增量同步机制,减少重复传输。最后,还需要根据训练任务决定数据传输方式。如果两个城市的GPU集群需要协同训练,还需要进一步考虑分布式训练通信,对网络时延和东西向带宽提出更高要求;如果只是进行数据集分发、模型文件同步和训练结果回传,则可以采用定时同步与高速专线相结合的方式。
对于这类业务,建议采用DCI高速互联方案,结合10G、40G或100G专线带宽、双链路冗余以及存储同步机制,构建两个城市之间稳定的算力数据传输网络。
亿联云提供MPLS专线、SD-WAN、企业专线及云专线等网络服务,可根据企业总部与各地营业部的实际分布,规划多分支组网方案,为核心业务系统提供稳定、安全的网络连接。
免责声明:本站发布的内容(图片、视频和文字)以原创、转载和分享为主,文章观点不代表本网站立场,请联系站长邮箱:shawn.lee@eliancloud.com进行举报,并提供相关证据,一经查实,将立刻删除涉嫌侵权内容。
标题:两个城市的GPU算力集群,如何实现高速互联?
TAG标签:
地址:https://www.elinkcloud.cn/article/2087.html
下一篇:没有了


 010-53390328
 service@eliancloud.com